


Heureka: Ich schickte um 1:30 Uhr ein Video an eine lokale KI. Um 6:29 stand die App
Um 01:30 in einer Augustnacht war ich schon im Bett. Ich hatte gerade noch ein Video von einem Coding-Agenten gesehen, der aus einer Spezifikation eine App baut - vieles, was er zeigte, hatte ich selbst schon vorher ausprobiert, mit anderen Tools und einem älteren LLM, aber immer lokal. Das neue Modell hatte woanders gute Bewertungen. Also tat ich es trotzdem, aus Neugier, in der Erwartung eines weiteren Fehlschlags - vermutlich.
Auf meinem Handy öffnete ich Telegram und schrieb meinem Agenten:
https://youtu.be/k2LLUKj6piE?si=nc4sB730kE6dC23Z
“Can you set up spec-kit and follow through the demo, but instead of using IBM Bob as coding agent, you should use
goose, which is already installed. Work in the folder...speckit_shoppinglist. Make it use SQLite, FastAPI, NiceGUI. For the constitution, import the.../guidelines/files and refer to the imported files. Do you have any questions about this assignment?”
(Gekürzt; der vollständige Prompt, wortwörtlich, steht im Anhang am Ende.)
Am nächsten Morgen um 06:29 schrieb der Agent zurück:
“Done. (…)”
(Im Anhang steht die vollständige Meldung. Sie lohnt sich - eine Stunde später grinste ich noch immer.)
Es war fehlerfrei! Irre – alles lief ausschließlich lokal auf meinem Rechner!
Ich war eingeschlafen. Meine Agenten arbeiteten weiter. Sieben Spec-Kit-Sessions waren in der Dunkelheit nacheinander gelaufen, und die App war gebaut, getestet und wartete.
Die einzige Hardware, die ich berührt habe, war das Handy. Die andere Hardware ist eine einzelne Workstation mit einer GPU in meinem Büro, dazu komme ich gleich.
 KI-generiertes Symbolbild.
Welche Schlüsse man schon jetzt aus diesem Experiment ziehen kann:
- Das Video war ein Lehrfilm. Es zeigte dem Agenten bei jedem Schritt, was als Nächstes kommt, also hatte dieser einen Weg zum Ergebnis bereits vorgezeigt bekommen. Mein Agent konnte dem gut folgen.
- Das Softwareprojekt im Video war einfach eine weitere Variante einer Todo-Liste (hier Einkaufsliste) für einen Browser, für ein LLM also per-se nichts Neues.
- Meine Änderungswünsche im Prompt machten die Aufgabe aber nicht mehr trivial, sie verlangte der KI also wirkliche Transferleistung ab. So musste z.B. eine andere Entwicklungsumgebung aufgesetzt und neue Pakete installiert werden. Die Schlussmeldung des Agenten gibt dabei bereits Hinweise darauf, dass dabei durchaus Probleme auftraten, die jedoch im Verlauf der Sitzung selbständig gelöst werden konnten.
Daraus leiten sich dann auch folgende Fragen ab:
- Wie schwer fällt es mir - bzw. welchen Aufwand muss ich investieren - damit ich selbst meine Agenten dazu bringe, ganze Software-Aufgaben selbstständig (d.h. ohne weiteren Eingriff im Verlauf der Arbeitsphase) zum Erfolg zu führen?
- Verstehe ich selbst es, diesen spezifikationsgetriebenen Ansatz auf andere eigene Projekte zu übertragen, und wie ist dann dabei vorzugehen?
- Welche Projekttypen eignen sich dann gegebenenfalls dafür und welche weniger?
- Falls dieser Ansatz es tatsächlich möglich macht, die Agenten selbständig und unbeaufsichtigt mit Lösungen zu Softwareproblemen zu beauftragen, wie groß dürfen derartige Projekte dann werden, damit sie noch erfolgreich auf meiner lokalen Hardware bearbeitet werden können?
- Wenn ich dann schließlich auf Grenzen stoße - diese werden unweigerlich auftauchen - kann ich herausfinden, welche Faktoren diese Grenze maßgeblich bestimmen, um möglicherweise darauf neue Strategien zu finden?
Dieses Experiment war jedenfalls schon jetzt sehr aufschlussreich. Bevor ich mich aber nun daran mache auszutesten, wie und wie weit ich meine lokale KI vorantreiben kann (darüber soll es dann in den nächsten Artikeln gehen), ist es aber zunächst notwendig zu verstehen, auf welchen Grundlagen dieses Experiment bereits aufbauen konnte.
Was bereits da war
Das ist kein Stack, den ich an einem Nachmittag entworfen habe. Es ist das Ende eines langen, manchmal frustrierenden Wegs, der mit einer einzelnen Grafikkarte begann.
Oktober 2024. Die erste Karte, eine NVIDIA RTX A6000 (48GB VRAM) - mein Einstieg in lokale KI. Die ersten Modelle direkt von ollama.com, was gerade passte, z.B. gemma-2, llama3, phi-3, qwen2.5-coder, usw. Dann der LAN-Server: Ollama auf einer Windows-11-Maschine kann von allen Rechnern im LAN genutzt werden, mit Open-WebUI und ChatBox darauf ausgerichtet.
2025 Experimente mit Python-Frameworks (CrewAI, langchain, RAG), Prompt-Engineering, die ersten aider-Läufe. Überall Agent-GUIs, eigene Python-Skripte, Jupyter-Notebooks, die über Bibliotheken den Ollama Server “anzapfen”.
2026 Gleich im Januar: OpenClaw wird überall gehypt - der erste Agent, der mit mir in einem Chat-Fenster sprach, über Telegram. Der sich verbessern konnte, sich mal über das Ziel hinausschoss. Ich verbrachte Nächte damit, Guidelines zu schreiben (schreiben zu lassen) - große Mengen an Markdown-Dateien -, damit OpenClaw Code genau so schreibt, wie ich es will. Dennoch lief er immer wieder an derselben Stelle gegen die Wand: Man konnte stundenlang chatten, tonnenweise Markdown erzeugen, aber regelmäßig scheiterte er daran, die Aufgaben bis zum Ende durchzuziehen. Die 60-80%-Grenze (der Fehlermodus, auf den die ganze Serie eine Antwort ist).
Dennoch: Diese Guidelines aus der OpenClaw-Zeit bildeten die Grundlage für Regeln, die die Agenten beim Nachbilden des Projekts aus dem Video zu befolgen hatten (was ihnen auch ganz gut gelungen war).
März 2026. Eine neue Maschine: eine NVIDIA RTX PRO 6000 Blackwell (Max-Q-Workstation-Edition). Größere Open-Weight-Modelle - 70B-Klasse, 120B-Klasse (gpt-oss:120B) - und die Grenze war trotzdem noch da.
Also musste die Lösung aus dem Harness kommen, nicht aus den Gewichten. Es kam hermes auf der CLI (er übernahm das Telegram-Konto vom inzwischen stillgelegten OpenClaw), dann eine goose-GUI, deren recipes-Konzept mich neugierig machte. Schließlich las ich den Heise-Überblick über Spec-driven-Development-Tools, probierte darauf hin OpenSpec aus. Es war zwar solide, aber auch nicht vollständig überzeugend und so suchte ich weiter - bis mir dieses YouTube-Video vorgeschlagen wurde.
So passierte die Heureka-Nacht unten: Ich lag bereits im Bett, goose war nicht erreichbar, nur hermes via Telegram war noch ansprechbar - und alles kam unerwartet zusammen.
Der 60-80%-Wall, der jeden obigen Meilenstein heimsuchte, ist der Grund, warum dieser Artikel existiert. Dass diese Schwachstelle in dieser einen Nacht nicht zum Vorschein trat, ist nun meine Motivation für alle weiteren Untersuchungen.
Und das Wie - wie die zwei Ebenen tatsächlich zusammenarbeiten, soll genauso untersucht werden wie die Frage, ob und warum vLLM auf der Blackwell GPU besser sein wird (und auch wie man dies misst).
Ich werde das Setup weiter ausbauen und verfeinern, weitere Tools in den Werkzeugkasten legen, Git als Repository könnte mit den Commit-Meldungen möglicherweise zu einem externen Agent-Gedächtnis werden - all das ist, worüber die folgenden Artikel handeln werden.
Die Hardware: eine Karte, kein Cluster
In dieser Nacht kam einzig meine Workstation zum Einsatz, kein externer Provider: eine NVIDIA RTX PRO 6000 Blackwell (Max-Q-Workstation-Edition), 96GB VRAM. Auf ihr läuft zu diesem Zeitpunkt Ollama, das ein Q8-quantisiertes 27B-Modell serviert - den qwen3.8:27b-mtp-q8_0-Build, 8-Bit-Gewichte, die mtp-Variante der Modellfamilie. 27B ist eine ernsthafte Größe für eine einzige Workstation-Grafikkarte, die bei einer Kontext-Größe von 256k Token ca. 47GB belegt, und damit sogar in den 48GB Speicher meiner NVIDIA RTX A6000 passen würde.
Und genau darum geht es in dieser Geschichte: Dieses Modell ermöglicht es, dass die Agenten eine einzige lokale GPU verwenden können, damit sie mit Hilfe der vorgegebenen Anleitung des Videos selbstständig die Software nachbauen und sogar noch in eine neue Entwicklungsumgebung und Programmiersprache portieren können.
Der Serving-Stack zu jener Zeit war Ollama 0.32.13. Das Kontextfenster des Modells ist 256K Tokens; die Zahl, die die ganze Nacht zählte, war eine andere - sie kommt gleich.
Die zwei Ebenen des Runs, beide auf demselben (virtuellen) Rechner - meine Agenten leben auf der Workstation in einem abgeschotteten Bereich - nutzten also gemeinsam das gleiche lokal gehostete LLM:
- Worker -
goose1.46.0 als Coding-Agent, der die Spec-Kit- Phasen ausführte und - Supervisor - der Orchestrator (Hermes), der die Phasen koordinierte, die Evidenz prüfte und jede Behauptung des “Workers” nachprüfte.
Beide liefen auf demselben lokalen Modell qwen3.8:27b-mtp-q8_0.
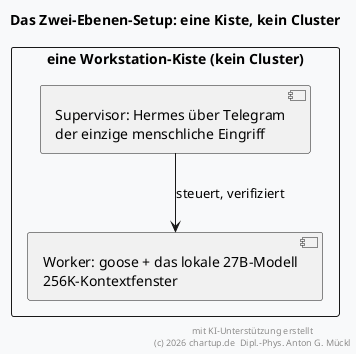
Die Aufgabe selbst kam als kleine Web-App heraus: SQLite für die Persistenz, FastAPI für die API, NiceGUI für die Oberfläche - exakt wie im Prompt vorgegeben und gebaut nach dem Rezept eines Videos nach meinen Vorgaben, die ich in einer Telegram-Nachricht von meinem Handy gesandt habe.
Was wirklich geschah, Stunde für Stunde
Der komplette Austausch ist aus zwei unabhängigen Protokollen rekonstruierbar - dem eigenen Session-Ledger des Coding-Agenten und dem State-Store des steuernden Orchestrators - deshalb ist die Zeitachse gemessen, nicht nur nacherzählt:
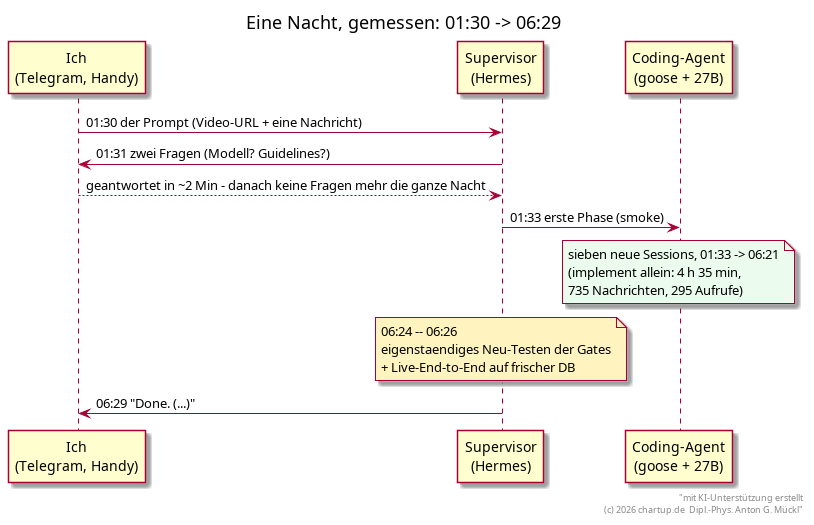
- 01:30 - der Prompt kommt an. Der Orchestrator macht einen Pre-Flight: der Coding-Agent (
goose1.46.0),specifyunduvsind da; er holt das Transkript des Demo-Videos, um der Demo präzise zu folgen, statt zu raten, was sie zeigt. - 01:31 - er pausiert und stellt zwei Fragen, bevor er eine einzige Phase startet: welches Modell (ich bestätige den Standard, das lokale 27B) und wie meine Guidelines importiert werden sollen (ich wähle: die fünf Dateien wortwörtlich kopieren). Beides sind günstige, durch Standardwerte abgesicherte Entscheidungen. Ich antworte in etwa zwei Minuten, halb schlafend. Er fragt nie wieder.
- 01:33 - 06:21 - die Spec-Kit-Phasen laufen nacheinander ab, jede in einer frischen Session (kein Resume; der Zustand wandert nur über die Artefakte des Repos): smoke, constitution (zweimal), specify, plan, tasks - und eine Implement-Phase von 4 h 35 m: 735 Nachrichten, der ganze Build. Die Implement-Phase ist der Ort, an dem ein agentischer Loop lebt oder stirbt: das lange, wachsende Gespräch - und der Punkt, an dem Modelle der vorherigen Generationen anfingen zu skidden.
- 06:24 - 06:26 - der Supervisor läuft die Gates eigenständig nach und macht ein sauberes End-to-End gegen eine frische Datenbank.
- 06:29 - “Done. (…)”
Die Zahl, die alles erklärt
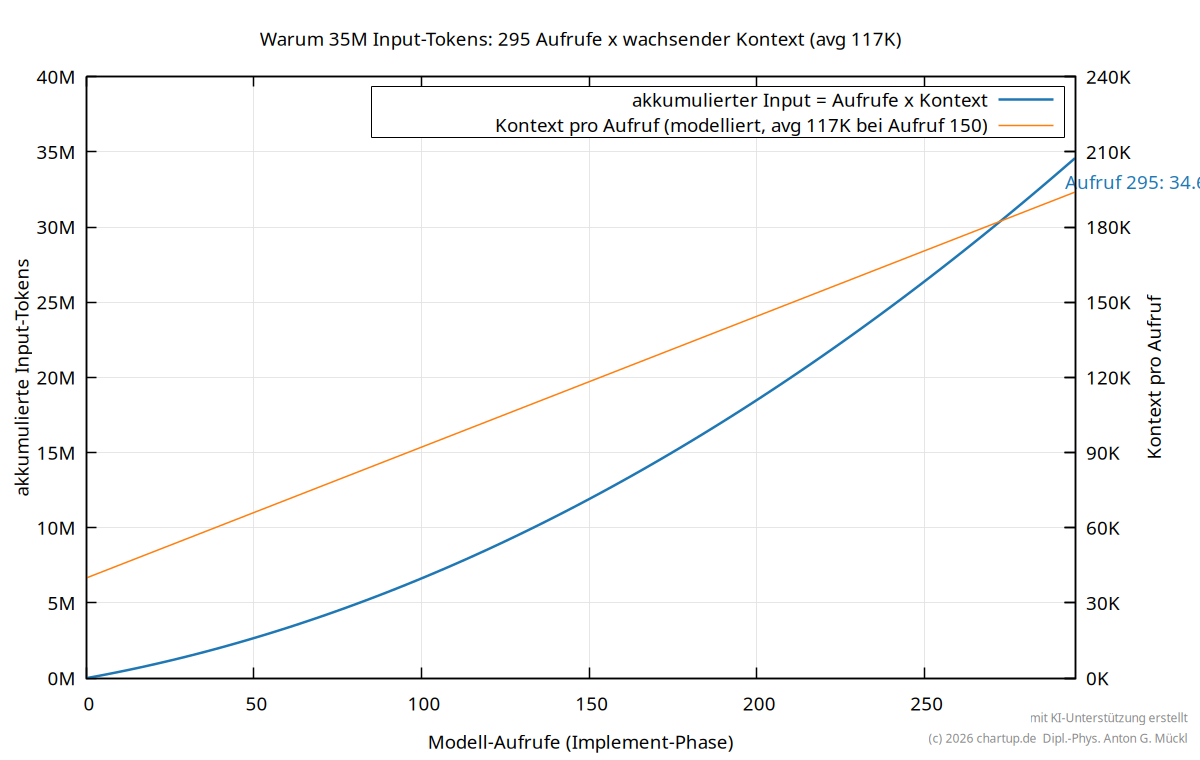
Die Implement-Phase machte 295 Modell-Aufrufe. Jeder Aufruf schickt das gesamte (wachsende) Gespräch erneut - so funktioniert ein agentischer Loop: Das Modell erinnert sich nicht an den letzten Turn, es erhält das komplette Gespräch erneut. Die abgerechnete Input-Menge ist also nicht “ein großer Prompt”, sondern Aufrufe x Kontext. Der durchschnittliche Kontext pro Aufruf in der Implement-Phase lag bei etwa 117K Tokens, und 295 solcher Aufrufe summieren sich zu:
| Bereich | Input-Tokens | Output-Tokens |
|---|---|---|
| Worker (goose), ganze Nacht (335 Aufrufe) | ~35,0M | ~0,2M |
| Supervisor (Hermes), ganze Session (413 Aufrufe) | ~36,4M | ~0,5M |
| Beide Ebenen | ~71,4M | ~0,7M |
Die Supervisor-Zeile ist die ganze Session (die Nacht plus das Journal und die Sanierungsarbeit des nächsten Morgens), also eine obere Grenze für die Nacht allein; die Worker-Zeile ist per Konstruktion nur die Nacht.
Output ist 0,6 % des Inputs. Die Kosten agentischer Inferenz leben auf der Input-Seite und skalieren als Aufrufe x Kontext - nicht als ein großer Prompt. Zwei Folgerungen, beide messbar:
- Das 256K-Kontextfenster ist Entscheidend. Ein so langer Agenten-Lauf lebt oder stirbt mit der zur Verfügung stehenden Fenstergröße. Und dieses Setup hielt bei dem eingesetzten 27B Model sogar immer noch Reserve bereit. Falls Kontext-Kompressionen überhaupt auftraten, führten diese nicht zu ersichtlichen Genauigkeitseinbußen.
- Der gesamte Tokenverbrauch ist das, was zusammen kommt, wenn die GPU dann richtig beansprucht wurde: siebzig Millionen Input-Tokens über beide Ebenen auf einer Workstation-Karte über Nacht - und sie musste nicht aus einem Rechenzentrum prefillen.
Legte man einen marktüblichen Preis für einen öffentlichen API-Tarif für das hier eingesetzte LLM zugrunde, wären damit etwa 12 US-Dollar für die ganze Laufzeit, also beide Agenten zusammen genommen, aufgelaufen. Bei einem lokal laufenden LLM-Server ist Strom der einzige Kostenverursacher: Die Karte verbraucht praktisch konstant 300W, während sie die Anfragen bearbeitet. Messwerte zum Leerlauf-Verbrauch der Workstation müssen noch bestimmt werden, ich werde in einem späteren Teil davon berichten.
Gegen eine Token-Rechnung von etwa 12 US-Dollar fällt der angefallene Stromverbrauch auf jeden Fall wesentlich geringer aus.
“Error-free” - der Anspruch, ehrlich überprüft
Die erzeugte App habe ich selbst getestet und auch gereviewed. Dabei kann ich tatsächlich bestätigen, dass der generierte Code fehlerfrei ist. Und ehrlicherweise müsste ich mir eingestehen, dass ich selbst diesen Quellcode vermutlich nicht so sauber geschrieben hätte.
Darüber hinaus führte der Supervisor die Gate-Prüfungen auch noch eigenständig aus: 40 Tests bei 82 % Abdeckung, ruff sauber, strikter Type-Check sauber, dazu ein live End-to-End-Abnahme mit neu aufgesetzter Datenbank, inkl. dem Nachweis der Persistenz über einen Prozess-Neustart hinaus.
Die Verifikationskette ist dreistufig: die eigenen Test-Runs des Coding-Agenten, die unabhängigen Überprüfungen des Supervisors, und dann meine Usability-Tests und Code-Review.
Und die ehrliche Lücke, die ich nicht unter den Teppich kehren möchte:
Bei diesem Experiment sind die ursprünglich als pre-commit gates vorgesehenen automatischen Überprüfungen vor jedem Einchecken in das Git Repository nicht aktiviert worden, vielmehr wurden sie stillschweigend fallen gelassen - Mein Setup war zu diesem Zeitpunkt noch nicht auf Spec-Kit ausgerichtet, sodass die Regeln, die normalerweise zur Setup-Zeit gelten sollten, aus Sicht von Spec-Kit außerhalb des Geltungsbereichs lagen.
Ich fing das erst am nächsten Morgen ein und behob dies mit einem weiteren Prompt. Der Code bestand seine Gates; der Prozess hatte eine Lücke, die der Agent nicht offenlegte - sie war ihm schlicht nicht bewusst. Diese Lücke ist Thema eines späteren Beitrags (Etablierung einer automatisierten Prüfung zur Einhaltung von Qualitätsstandards) - dies wird noch eine sehr interessante Geschichte werden.
Was ich nicht behaupte: Dieses Konstrukt “funktioniert tadellos auf großen Projekten”. Dieser Anspruch bräuchte ein kontrolliertes Messverfahren - eine feste Aufgabenmenge über mehrere Konfigurationen - ich werde dies in den nächsten Artikeln dieser Serie immer weiter vorantreiben und darüber berichten.
Was ich als gefühlte Beobachtung jedoch schon sagen kann:
Zum ersten Mal schaffte es ein Duo von Agenten mit einem lokalen Modell, ein Projekt zum Ende zu bringen, anstatt bei dem schwierigen Teil der Implementierung zu scheitern, weil der Kontext immer mehr anschwillt und die Informationsmenge dann oftmals dem LLM zu viel wird, weshalb die bisher verwendeten lokalen Modelle regelmäßig ins Straucheln kamen und kein vernünftiger Code mehr erzeugt werden konnte. An ein Debuggen war dann oftmals erst recht nicht mehr zu denken, denn dazu hätte das Kontextfenster in der Regel ja noch viel größer sein müssen, um zusätzlich zu den initialen Informationen, dem fehlerhaften Code dem LLM dann auch noch zusätzlich Debug-Informationen zur Verarbeitung und Fehlerbehebung übergeben zu können.
Bisher hatte ich regelmäßig beobachtet, dass LLMs beim Erreichen eines Füllstands um die 60-80 %-Marke anfangen, nicht mehr in der Lage waren, präzise genug Texte (Code sind sehr präzise Texte) ausgeben zu können. Diese Schwachstelle wurde beim Experiment nicht mehr offensichtlich, was jedoch nicht alleine dem verwendeten Modell zugerechnet werden kann, sondern dem verwendeten Gesamtkonstrukt aus LLM, zwei passenden Agenten im Zusammenspiel mit dem spezifikationsgesteuerten Ansatz von Spec-Kit als Ganzes.
Wohin das führt
Das war der Ollama-Proof-of-Life. Der nächste Schritt wird sein, dasselbe Zwei-Stufen-Setup für echte Projekte zu nutzen - dabei wird dann auch der Token-Durchsatz eine zunehmend größere Rolle spielen, da mit zunehmender Projektgröße auch die Rechenzeiten ansteigen. Für einen Produktiv-Einsatz dieses Setups ist nicht nur die Qualität der erzeugten Dateien - diese hat selbstverständlich oberste Priorität - von enormer Bedeutung, sondern auch die Wartezeit, bis diese Dateien zur Verfügung stehen.
Daher wird neben der Machbarkeit dieses agentischen Ansatzes vor allem auch die Geschwindigkeit, d.h. hier insbesondere die Tokenrate, mit der die Hardware bei der Inferenz Texte zusammenstellen kann in den Fokus kommen. Dabei stellt sich dann die Frage, ob Ollama - ein guter Allzweck-Server - noch geeignet ist, eine Agenten-Nacht mit 295 Aufrufen zu versorgen. Mit vLLM existiert z.B. eine Serving-Engine, die auf genau diesen Verwendungszweck zugeschnitten ist.
Deshalb werde ich für meine Workstation dann ein dediziertes vLLM-Backend mit zwei quantisierten Instanzen nebeneinander aufsetzen, und für die Hardware speziell optimierte quantisierte Modelle laden, die eine deutlich höhere Tokenrate versprechen. Auch dazu wird es einen Artikel geben.
Fürs Erste kann ich aber feststellen: Die Frustration des 60-80 %-Skids? Weg!
Anhang: die zwei Meldungen im Volltext
Der Prompt (01:30)
Geschickt am 2026-08-21 23:30:02 UTC (01:30:02 lokal) als erste Meldung der Session 20260821_233002_17f34f24. Wortwörtlich aus dem Session-Store des Orchestrators, ohne Normalisierungen; die Ordner-Pfade und Produktnamen sind, wie gegeben (öffentlich).
https://youtu.be/k2LLUKj6piE?si=nc4sB730kE6dC23Z

Can you setup spec-kit and follow through the demo, but instead of using IBM Bob as coding agent, you should use "goose" which is already installed. Work in the folder ~/projects/goose/projects/speckit_shoppinglist. Make it use Sqlite, fastapi, nicegui. For the constitution import the ~/projects/goose/projects/mydu_tkinter/guidelines/ files and refer to the imported files. Do you have any questions about this assignment?
Die Antwort (06:29)
Die vollständige Meldung, wortwörtlich aus dem Session-Store des Orchestrators, wie sie am 22. August 2026 um 06:29 verschickt wurde. Zwei Normalisierungen, beide offengelegt: Satzzeichen in plain ASCII (Striche und Pfeile), und ein interner Maschinenname durch “die Kiste” ersetzt (der Redaktions-Standard, den die Quellen-Notiz zitiert).
Done. The full Spec Kit demo ran through with goose (not IBM Bob) in `~/projects/goose/projects/speckit_shoppinglist`, using FastAPI + SQLite + NiceGUI, and the mydu_tkinter guidelines imported verbatim. Everything is committed (abc2da6, 57 files, tree clean).

## What was set up
- `specify init --here --integration goose --script sh` (v0.16.5) -- scaffolded `.specify/`, `.goose/recipes/` (the six `/speckit.*` commands as goose recipes), `AGENTS.md`
- `guidelines/` -- the 5 mydu_tkinter files copied verbatim (diff-verified), as you chose
- Goose config untouched, per your instruction; it ran on the default goose provider pinned to the box (`qwen3.8:27b-mtp-q8_0`)

## The workflow, executed via goose
| Step | Artifact | Result |
|---|---|---|
| `speckit.constitution` | `.specify/memory/constitution.md` v1.0.0 | 6 principles: simplicity, fixed stack (FastAPI/SQLite plain SQL/NiceGUI), keyboard accessibility, local-only data, no unnecessary deps, **imported guidelines as binding authority** -- referenced by path only, guidelines win conflicts |
| `speckit.specify` | `specs/001/shopping-list/spec.md` | 4 user stories (add P1, toggle P2, delete P2, persist P3), Given-When-Then, FR-001..011, edge cases, 16/16 checklist. Non-goals: no auth, no sharing, no sync, no categories |
| `speckit.plan` | `plan.md` + research/data-model/contracts/quickstart | Constitution check: **all principles PASS, 0 violations** |
| `speckit.tasks` | `tasks.md` | 27 tasks, 7 phases, TDD-ordered, scenario->test traceability |
| `speckit.implement` | `src/shoppinglist/` (app, db, ui, `__main__`, 4 test modules) | 27/27 `[X]` |

The implement run took ~4.5h on the local 27b. Notable fights it worked through: a real NiceGUI async-handler bug (coroutines never awaited), a cross-thread event-loop issue in the UI test harness (fixed with a single-loop `prepare_simulation` setup), and basedpyright strict-mode cleanup (module-level routes, `exclude=["tests"]` reconciled with the guideline's `basedpyright .` command).

## Verification (my own independent re-runs after the run finished)
- `uv run pytest` -> **40 passed, 82% coverage** (gate: >=80)
- `uv run ruff check .` / `ruff format --check .` -> clean
- `uv run basedpyright` (strict) -> **0 errors, 0 warnings**
- Live E2E on a wiped DB, `127.0.0.1:8080`: empty list -> add milk+bread -> whitespace rejected (422) -> toggle (purchased) -> delete (204) -> **killed the process, restarted, state survived**: `[{"id":1,"name":"milk","purchased":true}]`. UI page 200, NiceGUI shell with 32 framework markers. Persistence across full process restart is proven twice (also inside goose's own Q4 test).

## Two things worth knowing
1. **Quirk discovered:** this machine's CPython build (3.14.3, "Mar 2026") accepts bare-comma multi-exception `except A, B:` clauses -- nonstandard, but consistently so across system and venv interpreters, which is why the app compiles and passes everywhere. Standard-grammar linters (like mine) flag it; the project's own toolchain does not.
2. `goose run --params` silently corrupts multi-line values (YAML re-serialization) -- single-line params only. Worth remembering for future goose recipes.

To run it: `cd src/shoppinglist && uv run python -m shoppinglist` -> http://127.0.0.1:8080/ (overrides: `SHOPPINGLIST_PORT`, `SHOPPINGLIST_DB`). The UI screenshot was skipped -- the headless `test_ui_smoke.py` (4 tests, in the green suite) already drives the real page in-process.

Want me to write the `making-of.md` (architecture, the four failure loops, decisions -- per your journaling convention), or leave the repo as is?